Robots.txt: qué bloquear, qué no y errores que cuestan visibilidad
Robots.txt: el fichero de un minuto que puede ahorrarte el servidor — o costarte la visibilidad
El robots.txt controla el rastreo, no la indexación: dice a los bots qué URLs pueden pedir, pero una URL bloqueada puede seguir apareciendo en Google si recibe enlaces — para sacarla del índice se usa noindex, no Disallow. Bien usado, concentra el rastreo en lo que importa y descarga el servidor; mal usado, esconde tu CSS, arrastra el bloqueo de un staging o intenta desindexar lo que así nunca se desindexará.
Es un fichero de texto plano en la raíz del dominio que los bots leen antes de rastrear: una petición de acceso que los bots serios respetan, no una barrera de seguridad ni una orden de indexación. Esta guía sale de un caso medido — una tienda online cuyo servidor se ahogaba en URLs de filtros — y del matiz sobre los bots de IA que casi todo el mundo cuenta mal.
“El robots.txt no es una lista de deseos de indexación: es la gestión del tiempo que los bots pasan en tu casa. Y eso se decide con datos, no con plantillas copiadas.” — Jesús Iturbide
Los tres trabajos que sí hace bien
Descargar el servidor: cerrar las rutas que generan URLs sin fin — filtros, búsquedas internas, carritos — reduce peticiones y procesos justo donde más duele.
Concentrar el rastreo: el tiempo que los bots no gastan en el laberinto lo dedican a las páginas que sí quieres posicionar.
Gobernar a los bots de IA: es el punto de control para decidir quién entrena con tu contenido y quién te cita en sus respuestas — dos cosas distintas, como verás.
Lo que viene: el método en cuatro pasos, qué bloquear y qué no, la tabla de bots de IA con lo que controla cada uno y los errores que cuestan visibilidad — con el caso real y sus cifras.
Entiende qué controla (y qué no)
El robots.txt gestiona el rastreo: qué rutas puede pedir un bot. No decide la indexación — una URL bloqueada puede seguir en Google sin contenido si recibe enlaces — y no protege nada: el contenido sigue accesible para quien tenga la dirección. Para desindexar, la página debe quedar accesible con noindex; para proteger de verdad, una contraseña. Cada herramienta a lo suyo.
Decide qué bloquear con datos
Antes de escribir una regla, dos comprobaciones. Primera: quién pide qué — los logs o las métricas del hosting dicen qué rutas concentran las peticiones de los bots. Segunda: Search Console — ninguna URL que vayas a bloquear debería tener datos de búsqueda; si los tiene, bloquearla es cortar una fuente de visitas. En el caso de la tienda, de 511 URLs con datos, cero eran facetadas: luz verde.
Escribe las reglas mínimas
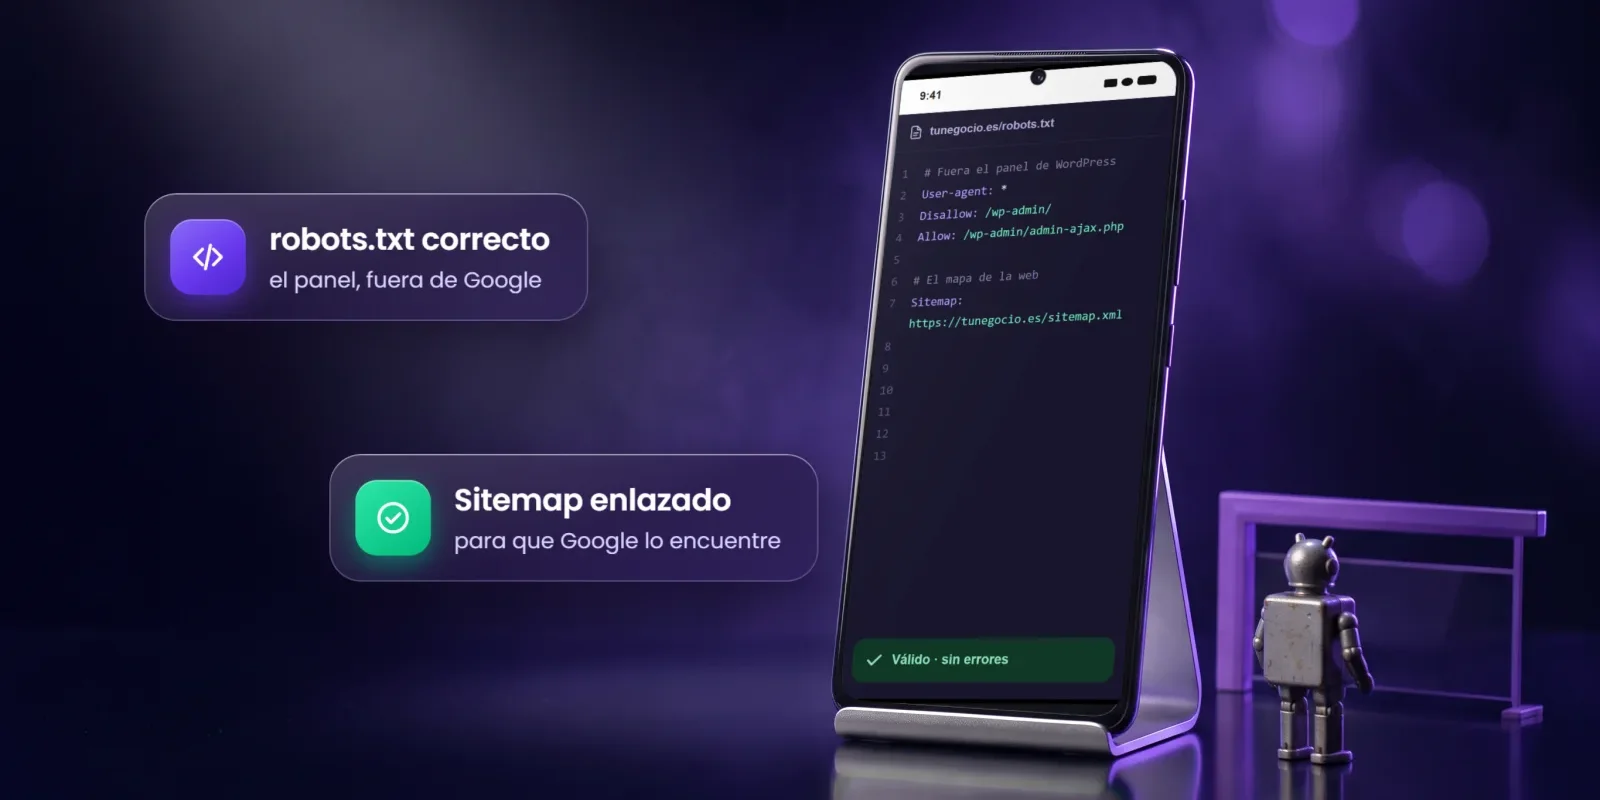
Un robots.txt sano suele ser corto: User-agent para decir a quién hablas, Disallow para cerrar rutas, Allow para abrir excepciones, y la línea Sitemap: anunciando dónde está tu mapa del sitio. Pocas reglas con motivo conocido ganan a una plantilla larga copiada de otra web — cada Disallow sin justificar es rastreo que pierdes sin saber qué ganabas.
Verifica lo servido, no lo guardado
El paso que casi nadie da: tras publicar el cambio, pide tudominio.com/robots.txt en una ventana de incógnito — o con curl — y lee lo que responde el servidor. En el caso real, la caché siguió sirviendo el robots.txt antiguo después del cambio; sin esa comprobación, el trabajo entero habría quedado en nada. Repite la lectura tras cada lanzamiento, migración o cambio de caché.
Rastreo no es indexación: la diferencia que explica todos los errores
Google trabaja en dos fases que conviene no mezclar: primero rastrea — pide URLs y lee lo que devuelven — y después decide qué indexa. El robots.txt actúa solo en la primera. La documentación oficial lo dice sin rodeos: sirve para gestionar el tráfico de rastreo, no para mantener una página fuera de los resultados. Casi todo lo que se hace mal con este fichero nace de ignorar esa frase — la mecánica completa la tienes en la guía de rastreo e indexación.
Las tres consecuencias prácticas
Bloquear no desindexa: una URL cerrada en robots.txt puede aparecer en Google sin contenido si recibe enlaces — el buscador sabe que existe aunque no pueda leerla.
Bloquear impide desindexar: para retirar una página del índice, Google tiene que leer su etiqueta noindex; si la ruta está bloqueada, nunca la verá. Primero accesible con noindex; después — si hace falta — el bloqueo.
Bloquear no protege: el fichero es público y cualquiera puede leerlo; lo confidencial se protege con contraseña o fuera de la web, nunca con un Disallow.
La sintaxis mínima que necesitas
Tres directivas y un anuncio. User-agent declara a qué bot hablas (el asterisco es «todos»); Disallow cierra una ruta o un patrón; Allow abre una excepción dentro de lo cerrado; y la línea Sitemap: dice dónde está tu mapa del sitio — con el antiguo ping por URL retirado, esa línea y Search Console son las dos vías por las que Google lo conoce. Un ejemplo del tipo que publicó la tienda del caso:
User-agent: *
Disallow: /?s=
Disallow: /*?color=
Disallow: /*?talla=
Disallow: /carrito/

Sitemap: https://www.tudominio.com/sitemap_index.xml
“Si no sabes qué hace una línea de tu robots.txt, no la publiques. Cada regla debe tener un motivo que puedas contar — y un dato detrás.” — Jesús Iturbide
El punto de partida: quién pide qué en tu servidor
Un robots.txt se escribe mirando datos, y los primeros están en tu hosting: los logs de acceso o las métricas de peticiones dicen qué rutas concentran el tráfico de bots. En el caso de la tienda, esa foto lo cambió todo: 1.895 peticiones desde 1.811 IPs distintas y el 97 % pidiendo URLs de filtros — color, talla, paginación —, con Googlebot como mayor consumidor recorriendo el laberinto. Sin esa foto habrías bloqueado por intuición; con ella sabes exactamente qué cerrar y qué esperar del cambio.
Lo que sí se bloquea: las URLs sin fin
Búsquedas internas, carritos y pasos de compra, filtros y ordenaciones, paginaciones combinadas: rutas que fabrican URLs infinitas sin contenido propio. Son el terreno clásico de las tiendas online, donde cada combinación de color, talla y orden crea una dirección nueva que compite por el rastreo con las fichas que sí venden. La condición: comprobar antes en Search Console que ninguna aporta búsquedas.
Lo que no se bloquea nunca
CSS y JavaScript, porque Google renderiza las páginas como un navegador y sin los recursos evalúa una versión rota de tu web. Las páginas que quieres desindexar, porque el bloqueo impide justo que Google lea el noindex que las retiraría. Y nada «por si acaso»: una regla que no sabes explicar es una regla que no deberías publicar — si heredaste un fichero largo, audítalo línea a línea antes de mantenerlo.
Bots de IA: dos familias, dos decisiones
Los bots de entrenamiento — GPTBot, ClaudeBot, Google-Extended, Applebot-Extended, Meta-ExternalAgent, CCBot — recogen contenido para entrenar modelos. Los de búsqueda — OAI-SearchBot, Claude-SearchBot, PerplexityBot — alimentan los índices con los que esas herramientas responden citando fuentes. Bloquear a los primeros no te saca de las respuestas con IA; bloquear a los segundos, sí. Decide cada familia por separado.
User-agent, Disallow y Allow: la gramática entera
User-agent declara a qué bot va dirigido el bloque (el asterisco es «todos»); Disallow cierra una ruta o un patrón; Allow abre una excepción dentro de lo cerrado. Con esas tres directivas se escribe prácticamente cualquier robots.txt útil — la dificultad nunca está en la sintaxis, sino en decidir qué cerrar.
La línea Sitemap: el anuncio que sí ayuda
Una línea con la URL completa de tu mapa del sitio — en WordPress, /wp-sitemap.xml el nativo o /sitemap_index.xml con Yoast. Con el antiguo ping por URL retirado, las vías que quedan para darlo a conocer son Search Console y esta línea, que además lee cualquier otro buscador. Cuesta una línea; ponla.
Facetas y parámetros: el laberinto de las tiendas
Cada filtro y cada ordenación añade parámetros a la URL, y las combinaciones se multiplican solas: color por talla por precio por página. Ninguna de esas direcciones es una URL limpia que quieras posicionar — son variantes de la misma categoría. Bloquear los parámetros conflictivos devuelve el rastreo a las páginas que sí trabajan. Con una advertencia: bloquear y marcar canónica son vías alternativas, no acumulables. Si lo que te duele es la carga del servidor, bloquea; si prefieres que Google las rastree y las agrupe con su categoría, deja la canónica y no bloquees, porque una URL bloqueada no se lee.
GPTBot y compañía: cerrar el entrenamiento
GPTBot (OpenAI), ClaudeBot (Anthropic), Meta-ExternalAgent, Applebot-Extended y CCBot alimentan entrenamiento de modelos. Bloquearlos no toca tu SEO en Google ni tu presencia en la búsqueda con IA — esa va por otros bots. Es una decisión editorial y de negocio: si no quieres que tu contenido entrene modelos, ciérralos sin miedo.
Google-Extended, sin miedo (no toca tu ranking)
Google-Extended controla el uso de tu contenido en Gemini y Vertex AI. No es señal de ranking, no afecta a la Búsqueda y no afecta a AI Overviews, que se construyen con el rastreo normal de Googlebot. Traducción: puedes bloquear Google-Extended sin riesgo SEO — y no puedes salir de AI Overviews sin bloquear a Googlebot, es decir, sin salir de Google.
El Disallow: / heredado del staging
Los entornos de pruebas se publican con Disallow: / para que nadie los rastree. El clásico: la web se lanza y el fichero viaja con ella — la web nueva, recién estrenada, pidiendo a todos los bots que no entren. Tras cada lanzamiento o migración, abrir el robots.txt en el navegador es la comprobación de un minuto que evita semanas de invisibilidad.
¿Cómo se nota un robots.txt bien hecho?
Un cambio de robots.txt se mide en dos sitios — el servidor y Search Console — y se vigila en un tercero: el propio fichero servido. En el caso de la tienda, los tres contaron la misma historia.
En el servidor
Carga: tras publicar las reglas, la carga media bajó de alrededor de 20 a alrededor de 13 — el rastreo del laberinto de filtros era la diferencia.
Procesos: los procesos PHP de esa web pasaron de saturar la CPU a cero: cada petición de una URL de filtro era una página generada en vivo.
En Search Console
Informe Páginas: las URLs cerradas van apareciendo etiquetadas como bloqueadas por robots.txt — es lo esperado tras el cambio, no un error que corregir.
Rendimiento: las páginas que sí trabajan no deben perder nada; si hiciste la comprobación previa — cero URLs facetadas con datos de búsqueda —, no había nada que perder.
En el propio fichero
La lección más barata del caso: la caché sirvió el robots.txt antiguo después del cambio. Lo guardado no es lo servido hasta que lo compruebas — pide el fichero en incógnito tras cada cambio, cada purga de caché y cada lanzamiento, y léelo entero.
Primero el dato, después la regla
La secuencia que hace seguro cualquier robots.txt: logs o métricas del hosting para saber quién pide qué, Search Console para confirmar que lo que vas a cerrar no aporta búsquedas, y solo entonces la regla. Es la diferencia entre optimizar el rastreo y jugar a la ruleta con tu visibilidad.
El bloqueo no es un desindexador
Grábatelo: Disallow gestiona rastreo. Para retirar una página del índice, déjala accesible con noindex y espera a que Google la procese; para protegerla de verdad, contraseña. Usar el robots.txt para cualquiera de esas dos cosas garantiza el resultado contrario al que buscas — es el error más repetido del fichero.
¿Y si bloqueé una URL que ya estaba indexada?
Es la situación más incómoda del robots.txt: la URL sigue en Google — sin contenido — y el bloqueo impide que el buscador lea el noindex que la retiraría. La salida es ordenada: quita el bloqueo de esa ruta, deja la página accesible con su noindex, espera a que Google la procese y desaparezca del índice, y solo entonces — si el motivo era el rastreo — vuelve a cerrarla. El orden importa: cada paso habilita el siguiente, y saltárselo es quedarse en el limbo de la URL indexada que nadie puede leer.
¿Bloquear bots de IA me protege o me esconde?
Las dos cosas, según a quién bloquees. Cerrar los bots de entrenamiento — GPTBot, ClaudeBot, CCBot y compañía — evita que tu contenido entrene modelos y no toca tu visibilidad en ningún buscador. Cerrar los bots de búsqueda con IA — OAI-SearchBot, Claude-SearchBot, PerplexityBot — te borra de las respuestas que citan fuentes y enlazan a quien las da. Y el caso especial es Google: Google-Extended se puede cerrar sin coste, pero AI Overviews va con Googlebot — salir de ahí es salir de la Búsqueda. Mi criterio general: el entrenamiento es decisión tuya; a la búsqueda, déjala pasar.
Mi forma de trabajarlo (para que compares con criterio)
Soy consultor SEO independiente: la persona con la que hablas es la que ejecuta. Con el robots.txt trabajo igual que en el caso de la tienda: primero los datos del servidor — quién pide qué —, después Search Console para confirmar qué se puede cerrar sin coste, la regla mínima escrita con su motivo, y la verificación de lo servido tras el cambio. Ningún Disallow sin justificación, ningún cambio sin comprobación. En mi servicio de posicionamiento SEO tienes el detalle y cómo pedir una valoración sin compromiso.
Errores de robots.txt que cuestan visibilidad
Casi todos los destrozos de robots.txt vienen de la misma confusión: tratarlo como una lista de deseos de indexación. De ahí salen páginas bloqueadas «para desindexar» que nunca se desindexan y ficheros kilométricos copiados de otra web sin saber qué hace cada línea. Los otros dos clásicos son de descuido: el bloqueo heredado de un entorno de pruebas que viaja a producción, y el cambio publicado que nadie verificó — con una caché sirviendo la versión antigua mientras todos daban el problema por resuelto. Todos se evitan con el mismo hábito: cada regla con su motivo, cada cambio con su comprobación.
- Heredar el Disallow: / del staging al lanzar — la web entera pidiendo a los bots que no entren, hasta que alguien lo ve.
- Bloquear una URL para desindexarla: Google deja de leerla, no de mostrarla — y ya no puede ver el noindex que la retiraría.
- Bloquear CSS y JavaScript: Google renderiza como un navegador; sin los recursos, evalúa una versión rota de tu web.
Cada bot en su sitio: qué controla cada User-agent
| Bot | De quién es | Qué alimenta | ¿Bloquearlo afecta a tu SEO? |
|---|---|---|---|
| Googlebot | La Búsqueda — y con ella AI Overviews | Sí: bloquearlo es salir de Google | |
| Google-Extended | Entrenamiento (Gemini y Vertex AI) | No: ni ranking, ni Búsqueda, ni AI Overviews | |
| GPTBot | OpenAI | Entrenamiento de modelos | No en Google; te saca del entrenamiento, no de la búsqueda con IA |
| OAI-SearchBot | OpenAI | Búsqueda con IA (respuestas con fuentes) | No en Google; sí a tu presencia en esas respuestas |
| ClaudeBot | Anthropic | Entrenamiento de modelos | No en Google |
| PerplexityBot | Perplexity | Búsqueda con IA | No en Google; sí a tu visibilidad en Perplexity |
Revisa tu robots.txt hoy: la checklist
- ✅Abre tudominio.com/robots.txt en incógnito: ¿lo que se sirve es lo que crees haber publicado?
- ✅¿Sabes qué rutas concentran las peticiones de bots en tu hosting antes de bloquear nada?
- ✅¿Las rutas que vas a bloquear tienen cero datos de búsqueda en Search Console?
- ✅¿CSS, JavaScript y los recursos de la plantilla quedan fuera de cualquier Disallow?
- ✅¿La línea Sitemap: apunta a la URL real de tu mapa del sitio?
- ✅¿Has decidido bot a bot qué IA dejas pasar — y sabes si alimenta entrenamiento o búsqueda?
Conclusión: reglas con motivo, cambios con comprobación
El robots.txt es pequeño, gratuito y peligroso a partes iguales: un minuto de edición puede ahorrarte un servidor saturado — como en la tienda del caso — o sacarte de Google entero. La diferencia entre los dos finales no está en la sintaxis, que se aprende en una tarde, sino en el método: datos antes que reglas, noindex para desindexar, recursos siempre abiertos, bots de IA decididos familia a familia y verificación de lo servido tras cada cambio.
Si quieres seguir tirando del hilo, la guía de rastreo e indexación explica el proceso que este fichero gobierna, y la de SEO técnico lo sitúa dentro de la base completa de una web sana. Y si prefieres que lo revise yo — el fichero, el rastreo y lo que tu servidor está pagando de más —, en mi servicio de posicionamiento SEO tienes cómo trabajo y cómo pedir una valoración sin compromiso.
Un robots.txt sano cabe en una frase: cada regla con su motivo, cada cambio con su comprobación.
La importancia del SEO
para la visibilidad online
Del clic al lead: SEO orientado a captación
¿Por qué es esencial estar bien posicionado en pamplona?
En Pamplona, muchas búsquedas no son “informativas”: son decisiones rápidas. La gente busca, compara 2–3 opciones y contacta. Si no apareces en esa primera pantalla (orgánico y/o resultados locales), simplemente no entras en la lista.
Estar bien posicionado en Pamplona es esencial porque:
- Captas demanda existente: personas que ya quieren tu servicio en tu zona.
- Generas leads más cualificados: menos curiosos, más solicitudes reales.
- Compites con ventaja: no solo por precio, también por confianza y claridad.
- Construyes un canal estable: menos dependencia de acciones puntuales y campañas.
La clave es que Google entienda sin dudas qué haces y dónde lo haces, con una URL local clara (Pamplona) y el resto de páginas apoyando sin competir.
“Si no apareces cuando te buscan en Pamplona, el cliente elige a otro.”
Beneficios del SEO para Empresas y PYMES de Pamplona y Navarra
El SEO es un canal de captación: te pone delante de personas que ya están buscando tu servicio y te eligen si tu página responde mejor que la competencia.
Cuando está bien planteado, no solo aumenta la visibilidad: mejora la calidad de las visitas y la tasa de contacto (más formularios, llamadas o WhatsApp) porque alinea intención de búsqueda, contenido y señales de confianza.
- Más llamadas en Pamplona
- Visibilidad en Google Maps
- Clientes cerca, alta intención
- Confianza local para elegirte
¿Cuáles son los factores clave?
En Pamplona y cualquier ciudad
Creación de contenido local y útil
No vale con “hablar del servicio”: en Pamplona necesitas páginas que respondan a búsquedas con intención (servicio + Pamplona/Comarca), con precios/orientación, objeciones y un CTA claro. Una URL por intención (sin duplicados por ciudad) y contenido que demuestre que conoces el contexto local.
Optimización técnica que no frena
Que Google pueda rastrear e indexar sin problemas: velocidad móvil, títulos/H1 bien alineados, URLs limpias y una arquitectura que empuje la página local. Si la técnica falla, da igual lo demás: no subes o no mantienes posiciones.
Experiencia de usuario orientada a contacto
En local, el usuario decide rápido: tiene que entender en 10 segundos qué haces, dónde trabajas y cómo contacta. Menos fricción: navegación simple, confianza visible (proceso, reseñas si las tienes, datos coherentes) y CTAs accesibles.
Autoridad con enlaces y señales locales
No es “conseguir backlinks por conseguir”: es sumar relevancia local y sectorial. Directorios locales coherentes, menciones de entidades/medios de la zona cuando encaje y enlaces desde contenidos relacionados que apunten a tu página de Pamplona con anchors naturales.
¿Tienes dudas?
Ponte en contacto conmigo y resolveré tus preguntas
(+34) 679 93 12 79
contacto@jesusiturbide.com
Tipos de SEO
El SEO geolocalizado consiste en adaptar tu web para posicionar según dónde ofreces el servicio: ciudad, comarca o ámbito nacional. Así atraes búsquedas con intención real en tu zona (por ejemplo, Pamplona y Navarra) sin mezclar objetivos.
Según tu audiencia, cambia la estrategia: no es lo mismo competir en local (Maps + “servicio + Pamplona”) que en nacional, donde mandan contenido, autoridad y una arquitectura más amplia.
SEO Local en Pamplona
El SEO local es fundamental para las empresas que quieren atraer clientes en su área geográfica (por ejemplo, Pamplona y Navarra). Se trabaja la presencia local para aparecer cuando alguien busca tu servicio “cerca de mí” o por ciudad.
Google Business Profile (antes Google My Business), reseñas, términos geolocalizados, citaciones en directorios y contenido orientado a intención local.
SEO Nacional
Para empresas que quieren crecer más allá de su ubicación, el SEO nacional es clave: compites por búsquedas más amplias y necesitas una estrategia que escale sin depender de una ciudad concreta.
Keyword research competitivo, contenido orientado a intención, arquitectura de URLs jerarquizada (categorías y servicios), enlazado interno y linkbuilding de calidad para ganar autoridad.
SEO Internacional
El SEO internacional permite captar clientes en otros países e idiomas, mostrando a cada usuario la versión correcta de tu web según su ubicación y idioma.
Hreflang bien configurado, elección de estructura (ccTLD, subdirectorios o subdominios), adaptación real del contenido (no solo traducción) y keyword research por mercado según idioma y cultura.
Temporalidad
Temporalidad en el SEO: ¿Cuánto tiempo tarda en dar frutos?
El SEO es un proceso progresivo: no funciona de un día para otro, pero cuando se ejecuta con método se convierte en un canal estable de captación. Entender los tiempos de impacto ayuda a fijar expectativas realistas y a saber qué priorizar en cada etapa (especialmente si buscas resultados en un mercado local como Pamplona).
Corto plazo (0 - 3 meses)
Se realizan ajustes técnicos, optimización de contenido y primeras estrategias de linkbuilding. En esta etapa, los cambios en el rastreo e indexación pueden ser visibles, pero el tráfico orgánico aún no se incrementa significativamente.
Medio plazo (4 - 9 meses)
Los motores de búsqueda comienzan a reconocer y valorar los cambios implementados. Se observan mejoras en la autoridad del sitio, tráfico creciente y algunas palabras clave empiezan a posicionarse mejor.
Largo plazo (más de 9 meses)
Se consolida la estrategia SEO. El contenido optimizado, los backlinks de calidad y la experiencia del usuario bien trabajada generan un crecimiento estable y sostenido en los rankings y conversiones.
El tiempo de resultados varía según factores como:
- Competencia del nicho: cuanto más competido sea tu sector (y en local, tu zona como Pamplona), más trabajo y tiempo para ganar posiciones.
- Autoridad del dominio: un dominio nuevo suele necesitar más tiempo para generar confianza que uno con historial y señales sólidas.
- Estado de la web: si hay bloqueos técnicos (indexación, rendimiento, arquitectura), el SEO avanza más lento aunque el contenido sea bueno.
- Contenido y autoridad: publicar y mejorar contenido útil + conseguir referencias/enlaces de calidad acelera la consolidación.
La importancia de la constancia y las actualizaciones continuas
El SEO no es estático: cambian los algoritmos y cambia la competencia. Para mantener y mejorar el posicionamiento, es clave:
- Revisar y actualizar contenidos que ya posicionan (mejorar respuesta, estructura y intención).
- Ajustar on-page y enlazado interno según datos (impresiones, CTR, posiciones).
- Seguir construyendo autoridad con enlaces/menciones coherentes y de calidad.
- Cuidar rendimiento y experiencia móvil para no perder visibilidad por problemas técnicos.
Actualizaciones
Los contenidos deben revisarse y optimizarse regularmente
Algoritmos
Adaptar la estrategia egún las nuevas directrices de Google
Enlaces
Seguir construyendo el perfil de enlaces
UX / UI
Factores como Core Web Vitals y la tasa de rebote impactan en el ranking
“El SEO es un maratón, no un sprint. La clave está en la constancia, la calidad y la optimización continua.”
Preguntas frecuentes
¿El robots.txt saca una página de Google?
No. El robots.txt bloquea el rastreo, no la indexación: si la URL recibe enlaces, puede seguir apareciendo en los resultados sin contenido. Para sacarla del índice, la página debe quedar accesible con una etiqueta noindex, o eliminarse. Bloquearla es contraproducente: impide que Google vea justo la etiqueta que la desindexaría.
¿Debo bloquear los bots de IA como GPTBot?
Es una decisión de negocio, no de SEO: GPTBot alimenta el entrenamiento de modelos y bloquearlo no afecta a tu posicionamiento en Google — pero tampoco te saca de la búsqueda con IA, que usa otros bots como OAI-SearchBot. Si quieres aparecer citado en esas respuestas, deja pasar a los bots de búsqueda; el de entrenamiento puedes cerrarlo sin miedo.
¿Dónde se pone el robots.txt en WordPress?
En la raíz del dominio: tudominio.com/robots.txt. WordPress sirve uno virtual básico si no existe un fichero físico; puedes sustituirlo subiendo un robots.txt real o editándolo desde un plugin SEO como Yoast. Tras cualquier cambio, comprueba lo que se sirve en el navegador: una caché puede seguir entregando la versión antigua.
¿Qué pasa si mi web no tiene robots.txt?
Los bots entienden que pueden rastrearlo todo, y en una web pequeña eso rara vez es un problema. Lo es cuando la web fabrica URLs sin fin — filtros, ordenaciones, búsquedas internas —: sin reglas, el rastreo se dispersa y el servidor lo paga, como en el caso de la tienda. Un fichero mínimo, con las rutas conflictivas cerradas y la línea Sitemap:, ya cambia el comportamiento de los bots.
Especialista SEO. Ayudo a empresas a posicionar y captar clientes con diseño, desarrollo y posicionamiento seo.
Artículos relacionados
Sitemap XML: qué es, cómo crearlo y enviarlo a Google
Un sitemap XML es un fichero que lista las URLs importantes de tu web para que Google las descubra antes y mejor: no mejora el posicionamiento por sí mismo, pero
Google Search Console: guía práctica para sacarle partido
Search Console es la herramienta gratuita con la que Google te enseña tu web desde su lado: con qué búsquedas apareces, cuántos clics recibes, qué páginas tiene indexadas y cuáles
URLs amigables para SEO: estructura y errores a evitar
Una URL amigable es corta, legible y describe lo que hay detrás: tudominio.com/reformas-cocina/ en vez de tudominio.com/?p=1234 o /cat/12/item-8b3f.